


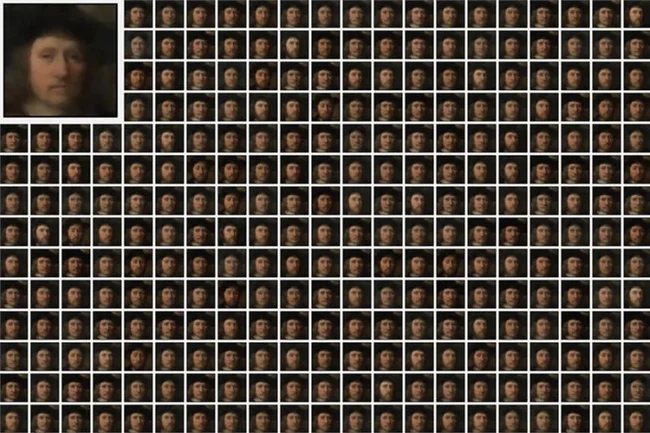
Ученые Лаборатории CSAIL Массачусетского технологического института выяснили, что при росте объема обучающих данных связь между тем, что модель видела, и тем, что она генерирует, почти исчезает. Это ставит под сомнение претензии правообладателей к разработчикам ИИ.
Для доказательства исследователи создали архитектуру «диффузионного ансамбля» — множество мелких компонентов, обученных на отдельных фрагментах данных. Отключая части, которые видели конкретное изображение, можно понять, как модель работала без него. Сравнение с 24 обычными моделями показало одинаковое качество результатов.
Появилось явление «затухания атрибуции»: при увеличении объема данных влияние любого конкретного элемента на итоговый результат снижается. При достаточных масштабах удаление любого изображения, либо всех работ одного художника, не меняет генерируемую картинку.
Если результат ИИ никак не связан с отдельными элементами из обучающего массива, его использование признаётся добросовестным даже без разрешения правообладателя. На языковых моделях это пока не проверено.
Ученые ввели термин «контрфактический радиус» — максимальное влияние отдельного элемента. Выяснилось, что чем больше данных, тем меньше этот радиус, а значит, меньше зависимость. Сравнения проводились попиксельно и по смыслу.