


Китайская лаборатория DeepSeek представила обновлённую компактную модель DeepSeek V4.1-Flash с поддержкой визуального восприятия. Она предназначена для быстрой обработки и генерации токенов с высокой пропускной способностью.
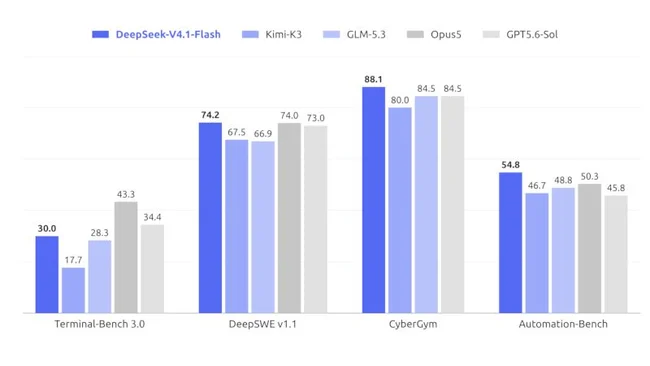
В тесте DeepSWE v1.1 модель набрала 74,2 балла, опередив GPT-5.6-Sol (73) и Claude Opus 5 (74). На CyberGym результат составил 88,1 — выше, чем у GPT-5.6-Sol и GLM-5.3 (по 84,5) и Kimi K3 (80).
В Terminal-Bench 3.0 модель набрала 30 баллов, обойдя GLM-5.3 (28,3) и Kimi K3 (17,7), но уступив GPT-5.6-Sol (34,4) и Claude Opus 5 (43,3).
Разработчики сократили использование KV-кеша — модель потребляет в четыре раза меньше памяти HBM и в восемь раз меньше места на SSD. Это позволяет существенно снизить затраты на работу ИИ-агентов.
Модель насчитывает 552 млрд параметров и использует архитектуру MoE с обновлённым Causal Encoder–Decoder: 8 млрд параметров на вводе и 16 млрд на выводе. Новые методы предобучения и масштабное обучение с подкреплением позволили превзойти даже флагманскую DeepSeek V4-Pro.
Модель уже доступна через API под именем deepseek-flash с нативной поддержкой мультимодальности. Действует гибкая тарификация: в непиковые часы цены ниже на 50%.
В непиковые часы: входные данные с кешем — $0,003 за 1 млн токенов, без кеша — $0,15, выходные — $0,60. В пиковые часы — $0,006, $0,30 и $1,20 соответственно.
С выходом V4.1-Flash прекращается поддержка моделей V4-Flash и V4-Flash-Vision-Exp — запросы к ним переадресуются на новую версию. Поскольку V4.1-Flash превосходит V4-Pro по скорости и производительности, с 14 сентября все запросы к V4-Pro также будут переведены на V4.1-Flash по её тарифам. Партнёры WorkBuddy, CodeBuddy и OpenCode уже объявили о поддержке новой модели.