

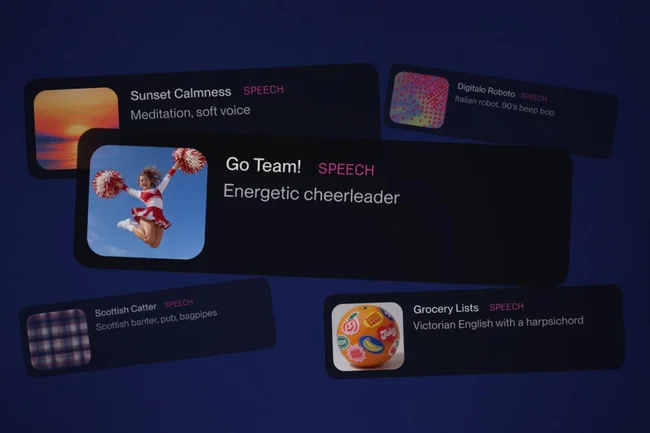
Suno, известная ИИ-генератором музыки, запустила функцию Speech: озвучку по сценарию или текстовому описанию. Публичная бета доступна в веб-версии и мобильных приложениях.

Suno, известная ИИ-генератором музыки, запустила функцию Speech: озвучку по сценарию или текстовому описанию. Публичная бета доступна в веб-версии и мобильных приложениях.
Google представила две новые модели синтеза речи — Gemini 3.8 Flash TTS и Gemini 3.8 Flash-Lite TTS. Вместо набора готовых голосов сервис теперь предлагает гибкий инструмент для создания аудио с собственными голосами и управлением каждой репликой.
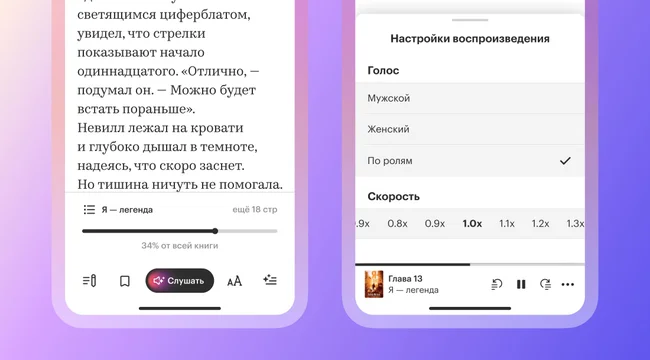
В приложении «Яндекс Книг» появилась озвучка книг по ролям. Виртуальный рассказчик анализирует текст, определяет реплики и назначает разные голоса в зависимости от пола. Можно включить только мужской или женский голос.
OmniVoice - открытая модель ИИ от Xiaomi для синтеза речи. Она клонирует голос, генерирует речь по описанию (возраст, пол, акцент), удаляет шумы и управляет интонацией, включая смех и вздохи.
Xiaomi представила два новых ИИ-инструмента для работы с голосом: MiMo-V2.5-TTS преобразует текст в речь, а MiMo-V2.5-ASR расшифровывает звук в текст. Обе модели понимают команды на английском и китайском, позволяя создавать сценарии с несколькими голосами или описывать желаемый тембр простым языком.