


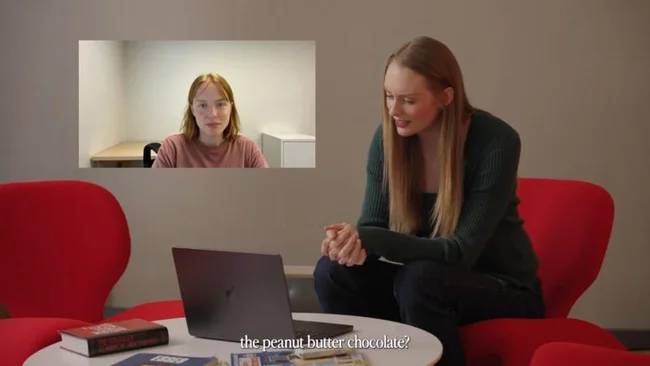
Американский стартап Tavus представил модель Griffin для общения по видеосвязи в реальном времени. Компания относит её к классу «моделей взаимодействия с человеком» (Human Interaction Model, HIM).
В эксперименте Tavus 26 из 54 участников (48 %) после минутного разговора приняли Griffin-Lite за человека. Разработчик назвал это первым прохождением теста Тьюринга в формате видеосвязи.
У результата есть оговорка: участникам заранее сказали, что они говорят с человеком. Тест показывает убедительность аватара в короткой беседе, но не доказывает, что система выдержит целенаправленную проверку.
Предыдущую систему Tavus в тех же условиях за человека приняли лишь 1 из 41 участника (2,4 %).
Более половины участников заявили, что во время разговора даже не думали, что собеседник может быть не человеком. Те, кто сомневался, обычно начинали подозревать подвох в первые 20 секунд.
Архитектура. Griffin описана как «полнодуплексная система „видео-в-видео“» из двух компонентов:
механизм моделирования диалога постоянно отслеживает звук и видео пользователя и в реальном времени решает, когда и как ответить;
механизм аудиовизуальной генерации синхронно превращает это решение в звук и видео.
Состояние диалога оценивается чаще чем раз в секунду. Пока пользователь говорит, Griffin может кивать, вставлять реплики, менять выражение лица и даже начинать отвечать. Пауза в речи не считается сигналом, что человек закончил.
Раньше использовали последовательную цепочку: распознавание речи, языковая модель, синтез речи, управление аватаром. Система должна была дождаться конца фразы пользователя, прежде чем отвечать.
Характеристики Griffin-Lite:
видео 720p, генерируется фрагментами по 320 мс;
клонирование голоса по десятисекундной записи;
лидерство над четырьмя генераторами видео по метрикам DOVER, FID и THEval;
средняя задержка преобразования звука в видео 0,43 с на Nvidia H100 (это не время ответа всей системы).
Отдельно модель оценила Nvidia в бенчмарке VideoFDB. За аудиовизуальное поведение Griffin-Lite получила 3,83 балла при человеческом эталоне 3,92.
В категории восприятия результат составил 3,73 балла против 4,20 у человека и 3,44 у ближайшего конкурента. Оценки ставит языковая модель по пятибалльной шкале. Они описывают отдельные стороны общения, а не общую эквивалентность человеку.
Griffin-Lite доступна ограниченному кругу тестировщиков. Перед широким запуском Tavus хочет доработать меры безопасности, включая уведомление собеседника о том, что он общается с ИИ.
Компания предлагает использовать систему для обучения, репетиции сложных разговоров и удалённой помощи пользователям.