


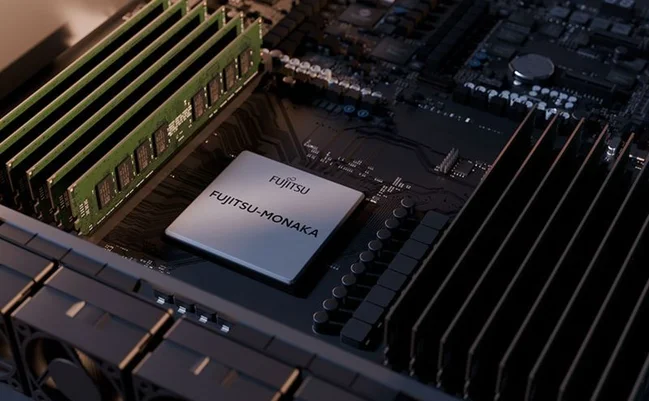
Fujitsu анонсировала старт глобальных продаж процессора нового поколения MONAKA в ноябре 2026 года. Параллельно выйдет сервер MONAKA Server для суверенной ИИ-инфраструктуры — заказы примут с ноября для ЦОД, предприятий, вузов, HPC-центров Японии и Европы, а также оборонного сектора. Массовые поставки стартуют в апреле 2027 года.
Чип ускоряет матричные операции аппаратно, поддерживает векторные вычисления SVE2 и, по заявлению Fujitsu, вдвое превосходит конкурентов по пропускной способности при ИИ-инференсе на уровне CPU.
MONAKA построен на 3D-стековой архитектуре: 2-нм техпроцесс для Arm-ядер, 5-нм — для кеша и I/O. До 144 ядер, частота до 3,8 ГГц, поддержка DDR5-8800. Ожидается упаковка Broadcom 3.5D XDSiP и технология Ultra Low Voltage для энергоэффективности.
Чип поддерживает конфиденциальные вычисления Arm CCA — шифрование данных и приложений прямо в оперативной памяти, включая многопользовательские облачные среды.
1U-версия работает с воздушным охлаждением при +40°C (2,1 ГГц) и жидкостным при +45°C (2,9 ГГц) без спецсистем. Фирменное охлаждение Fujitsu снижает энергопотребление систем охлаждения до 80%. На процессор — 12 слотов памяти, восемь слотов E3.S и два M.2, шина PCIe 6.0, поддержки GPU нет.
Серверы выйдут в форматах 1U (один-два сокета) и 2U (два сокета) для инференса и ИИ-агентов, а также 2U4N для HPC-задач вроде суррогатных моделей и CFD-расчётов.
2U-сервер получит два процессора (2,1 ГГц), 24 слота RDIMM, четыре слота E.3 и два M.2, поддержку GPU и только воздушное охлаждение. Многоузловой 2U с СЖО — восемь процессоров (2,9 ГГц), 96 слотов RDIMM, по паре E.3 и M.2 на узел с PCIe 6.0.
Серверы проектируют и производят в Японии, на заводе Fujitsu в Касашиме, с полной прослеживаемостью компонентов — для технологического суверенитета. Платформа объединит ИИ-решения Fujitsu Kozuchi и Takane с отраслевыми моделями. Серверы для MONAKA также разрабатывает Supermicro.
Память 1U-версии можно расширять через дезагрегацию и CXL, используя внешние пулы — это решает проблему нехватки памяти при инференсе и повышает гибкость под будущие ИИ-нагрузки.